RAG en IA : définition, fonctionnement et ce qu’il faut préparer.
Le RAG relie un modèle d’IA à vos documents : une recherche trouve les passages utiles, le modèle répond à partir d’eux. Définition, limites, préparation.
 Par Lilian, Ingénieur développement IAMis à jour le 13 novembre 20266 partiesChecklist incluse
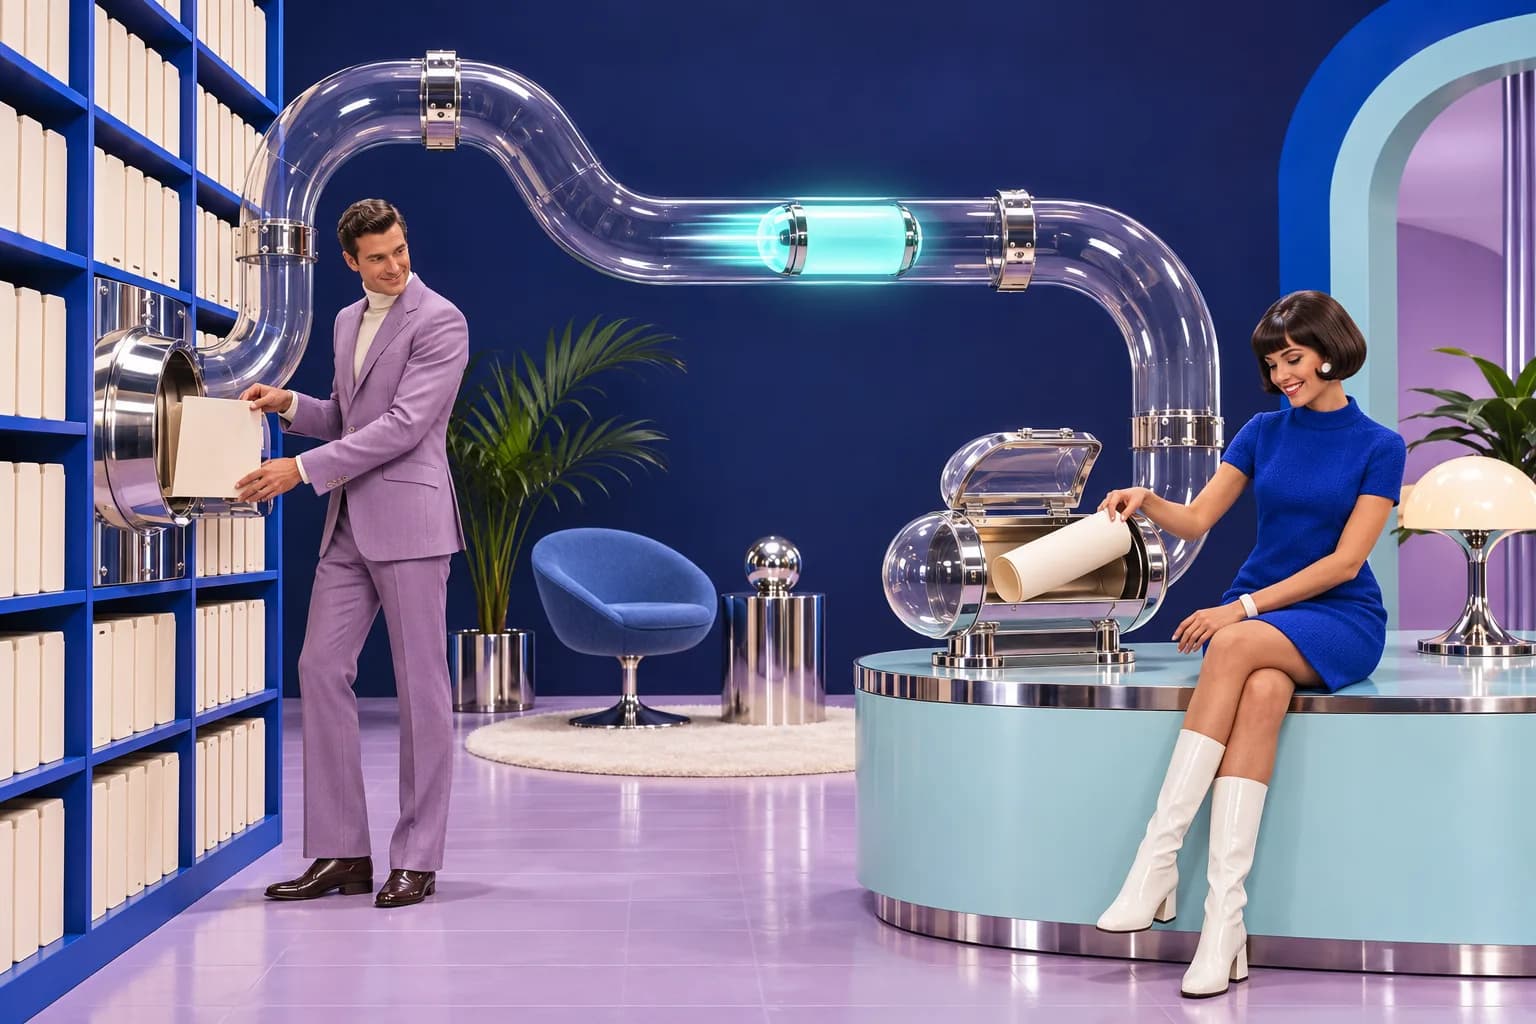
Un assistant d’IA répond avec la même assurance quand il ignore vos procédures. Le RAG lui donne vos documents à lire avant chaque réponse. Le résultat dépend alors de trois choses que vous maîtrisez : l’état de ces documents, les droits d’accès, et le type de questions posées.
Qu’est-ce que le RAG en IA ?
Le RAG, pour « retrieval-augmented generation » ou génération augmentée de récupération, relie un modèle de langage aux documents de l’entreprise. À chaque question, une recherche sélectionne les passages utiles, puis le modèle rédige sa réponse à partir de ces passages et peut citer ses sources.
La Direction générale des entreprises (DGE), qui lui a consacré un guide en novembre 2024, le définit comme « une technologie qui consiste à connecter des modèles d’IA générative à des bases de données internes à l’entreprise ». Le terme vient d’un article de recherche de Patrick Lewis et de ses coauteurs, déposé le 22 mai 2020.
En entreprise, le RAG prend par exemple la forme d’un assistant documentaire : un salarié pose une question en langage courant et reçoit une réponse rédigée, avec les documents d’où elle vient. Selon la DGE, la technique s’adopte sans compétence interne en IA, avec un produit du marché ou un intégrateur.
Quelle différence entre un LLM et un RAG ?
Un LLM, c’est-à-dire un grand modèle de langage, tire ses réponses de son entraînement, et ces connaissances sont figées à cette date. Un RAG est un système construit autour d’un LLM : il lui fournit, à chaque question, des passages tirés de vos documents.
La différence se voit le jour où une règle change. Le LLM seul l’ignore et répond quand même. Avec un RAG, vous corrigez le document et la réponse suivante en tient compte : le modèle n’est pas réentraîné.
Le RAG ne rend pas le modèle infaillible. La DGE écrit qu’il réduit les hallucinations, ces réponses fausses données avec assurance, mais qu’elles peuvent toujours se manifester.
Comment fonctionne un RAG ?
Un RAG fonctionne en deux temps : une préparation des documents, faite une fois puis à chaque mise à jour, et le traitement de chaque question. La DGE parle de deux modules, l’un de récupération d’informations, l’autre de génération.
- Les documents sont découpés en passages de quelques centaines de tokens au plus (un token est un mot ou un fragment de mot).
- Un modèle dit d’embedding convertit chaque passage en vecteur, une suite de nombres qui en représente le sens.
- Les vecteurs sont rangés dans une base vectorielle, que l’on interroge par proximité de sens.
- À chaque question, le système retrouve les passages les plus proches et les joint à la question.
- Le modèle rédige la réponse à partir de ces passages et indique d’où vient chaque affirmation.
Les deux étapes d’un assistant documentaire
Le trajet de votre question
- Votre question
- La recherche sélectionne des passages
- Le modèle formule une réponse avec ce contexte
Les deux étapes s’évaluent séparément : une réponse bien écrite peut partir d’un mauvais document.
Deux réglages pèsent plus que le choix du modèle. Le premier est la taille des passages, que la DGE tient pour un paramètre décisif, à fixer entre techniciens et personnes du métier. Le second est la citation des sources : la documentation d’Anthropic, par exemple, décrit une fonction de citations dont chaque référence pointe vers un passage du document fourni, ce qui permet au lecteur de vérifier.
RAG, fine-tuning ou long contexte : que choisir ?
Le RAG convient quand les connaissances changent et dépassent ce que le modèle peut lire d’un coup. Le fine-tuning modifie les paramètres du modèle pour améliorer ses réponses dans un domaine précis, au prix de ressources de calcul importantes, selon la CNIL. Le long contexte consiste à placer toute la documentation dans la requête.
| Votre situation | Voie adaptée | Pourquoi |
|---|---|---|
| Des documents nombreux, qui changent souvent | RAG | Corriger le document suffit, sans réentraînement |
| Un ton, un format ou un vocabulaire à faire respecter | Fine-tuning | Le modèle apprend une manière de répondre, pas des faits à jour |
| Une documentation de moins de 500 pages environ | Long contexte | Elle tient entière dans la requête |
| Un document à retrouver par son titre ou sa référence | Recherche classique | Aucun modèle n’est nécessaire |
Le seuil de la troisième ligne vient de la documentation d’Anthropic : une base de connaissances de moins de 200 000 tokens, soit environ 500 pages, peut être placée entière dans la requête, sans RAG. Mesurez le volume de vos documents avant tout projet. La quatrième ligne reprend une question du guide de la DGE : les résultats doivent-ils être intégrés à une réponse rédigée ? Si un lien vers le bon document suffit, un moteur de recherche interne fait le travail.
Quand le RAG ne convient-il pas ?
Le RAG convient mal aux questions qui portent sur toute la documentation, aux tableaux et aux décisions sur des personnes. La raison est mécanique : il ne lit que quelques passages par question.
- Les demandes globales. Un résumé de toute la base ou une comparaison entre de nombreux documents réclament une vue d’ensemble que la recherche de passages ne donne pas, note la DGE.
- Les tableaux. Le RAG est aujourd’hui plus performant sur du texte, selon la même source, et les documents qui mêlent texte, images et tableaux donnent de moins bons résultats.
- Les documents contradictoires. Si deux versions d’une procédure coexistent, l’assistant peut citer l’une ou l’autre. La correction se fait dans les documents, pas dans l’outil.
- Les décisions sur des personnes. Un RAG utilisé pour le recrutement pourrait être un système à haut risque au sens du règlement européen sur l’IA, prévient la DGE.
Que préparer avant de lancer un assistant documentaire ?
Trois préparations décident de la qualité des réponses : les documents, les droits d’accès et un jeu de questions de test. Aucune ne dépend du modèle choisi.
Les documents
Commencez par les documents qui répondent aux questions fréquentes, et désignez pour chacun un responsable de la mise à jour. La DGE détaille le nettoyage attendu : supprimer les doublons, corriger les erreurs, retirer les documents qui se contredisent, anonymiser ou pseudonymiser les données personnelles.
Les droits d’accès
Un assistant interne ne doit pas devenir une porte d’accès à tous les documents. L’ANSSI demande que le système tienne compte des droits d’accès et du besoin d’en connaître dans ses réponses : la recherche ne ramène que les passages que l’utilisateur a le droit de lire. Elle recommande aussi une revue régulière de ces droits, par exemple tous les mois.
L’ANSSI signale un second risque, l’injection de consignes indirecte : un mail reçu ou une page web peuvent contenir un texte qui détourne le modèle. Le risque grandit quand l’assistant peut agir sans validation humaine.
Les questions de test
Préparez des questions fréquentes, des questions ambiguës et des questions hors périmètre, avec la réponse et le document attendus. Vous vérifiez deux choses séparément : que la recherche ramène le bon passage, puis que la réponse le restitue sans le déformer. Vérifiez aussi que l’assistant sait dire qu’il n’a rien trouvé.
La mise en place d’un assistant documentaire avec RAG suit ces trois préparations, dans cet ordre. Si vos documents ne doivent pas quitter vos serveurs, le choix de l’hébergement est traité dans le guide IA locale ou cloud. Si le RAG est votre premier projet, la méthode de test est décrite dans par quel premier projet commencer.
Questions fréquentes
Un RAG peut-il encore inventer une réponse ?
Oui. Le RAG réduit les hallucinations sans les supprimer, écrit la DGE, qui recommande une évaluation régulière du système pour les détecter. Gardez la citation des sources visible et faites relire les réponses qui engagent l’entreprise.
Combien de temps faut-il pour mettre en place un RAG ?
Environ trois mois pour une solution personnalisée confiée à un intégrateur, selon le guide de la DGE. Un produit prêt à l’emploi se déploie plus vite. La durée varie avec la complexité du cas d’usage.
Faut-il des compétences en IA pour adopter le RAG ?
Non, selon la DGE : le RAG s’adopte sans compétence en IA ni en informatique en interne, avec un produit du marché ou un intégrateur. Il reste un travail que personne ne fera à votre place : trier les documents, fixer les droits et écrire les questions de test.
Qu’est-ce que le RAG agentique ?
Dans un RAG agentique, la recherche n’est plus un enchaînement fixe : des modèles spécialisés, appelés agents, se répartissent le travail pour améliorer la pertinence des réponses. La DGE range cette « agentisation du RAG » parmi les innovations en cours. Le guide IA agentique explique ce qu’un agent change, et ce qu’il demande en contrôle.
À préparer pour votre projet
- Les documents qui répondent aux questions fréquentes
- Un responsable de mise à jour par document
- Les droits de lecture par groupe d’utilisateurs
- Des questions de test avec la réponse attendue
- Le volume de la documentation, en pages